// contexto del proyecto
NYC Taxi Analytics & ML es un proyecto de análisis de datos masivos y modelado predictivo sobre el dataset público de taxis amarillos de Nueva York (2022), desarrollado íntegramente en Google BigQuery y visualizado en Looker Studio. Se trabajó con tablas derivadas particionadas por fecha y clusterizadas por zona porque, con millones de registros, escanear el dataset completo en cada consulta resulta lento y costoso; y para el modelado se usó BigQuery ML, que permite entrenar y evaluar modelos con SQL directamente sobre los datos, dividiéndolos por fecha para simular predicciones sobre viajes futuros. El proyecto incluye un análisis exploratorio con KPIs por zona, borough, hora y mes, y un modelo de regresión que predice la propina de cada viaje a partir de la tarifa, la distancia, la hora, el día y las zonas de origen y destino.
// retos técnicos
- Optimizar consultas sobre un dataset masivo creando tablas derivadas particionadas por fecha y clusterizadas por zona de origen y destino, reduciendo el tiempo de ranura de las métricas clave de 45 s a menos de 1 s.
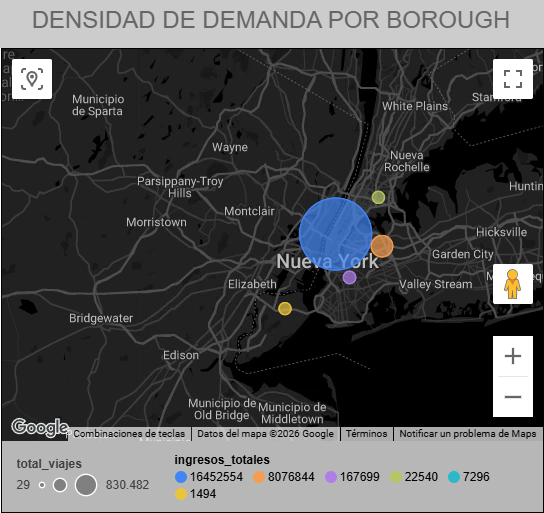
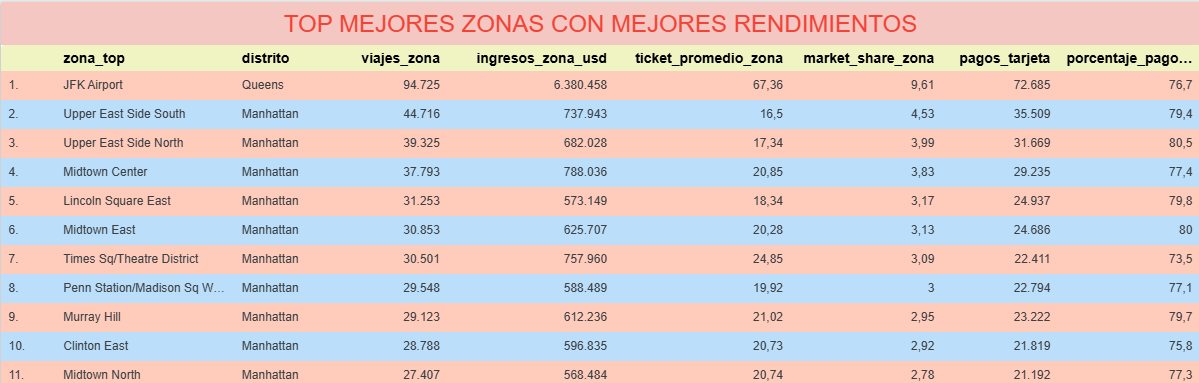
- Enriquecer los viajes con un JOIN contra las zonas geográficas (taxi_zone_geom) para calcular KPIs por zona y borough: market share, ticket promedio, revenue por milla y porcentaje de pagos electrónicos.
- Diseñar el dataset de Machine Learning con features derivadas (tipo de día y franjas horarias como rush de mañana o tarde) y una división temporal: enero–septiembre para entrenamiento (80%) y octubre–diciembre para prueba (20%).
- Entrenar y comparar cuatro modelos (Regresión Lineal y Boosted Tree, cada uno base y con hiperparámetros ajustados) usando MAE, RMSE y R², e interpretar sus pesos con ML.WEIGHTS.
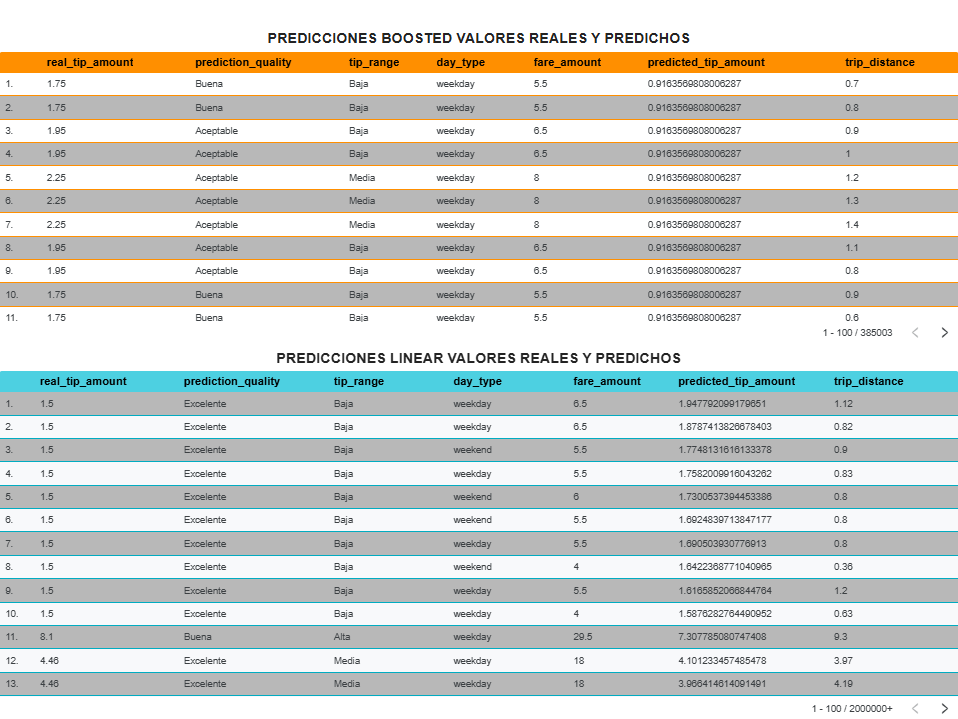
- Diagnosticar un modelo subajustado (R² negativo) que predecía un valor constante, y explicar por qué la regresión lineal falla con propinas atípicas cercanas a $50.
// resultados obtenidos
- La Regresión Lineal base resultó el mejor modelo: explica el 68.8% de la variación de la propina con un error promedio de $1.10, y en la mitad de los viajes se equivoca por $0.53 o menos.
- El modelo generaliza bien: su R² en prueba (0.688) es muy similar al de entrenamiento (0.675), sin señales de sobreajuste.
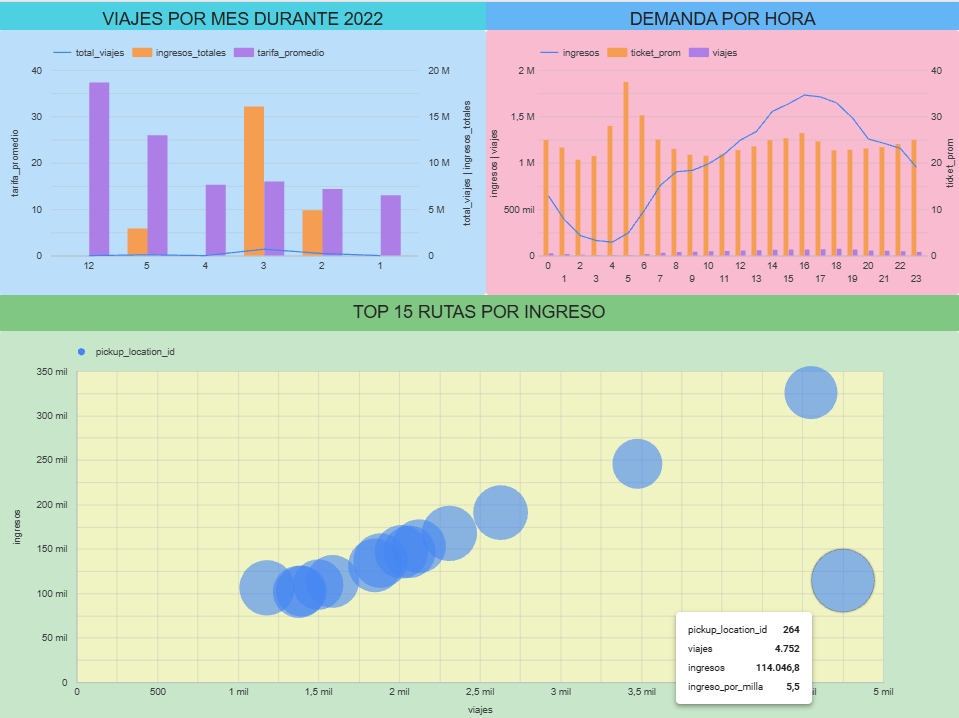
- Hallazgos de negocio: los aeropuertos JFK y LaGuardia generan el ticket promedio más alto (~$67 frente a ~$20 en Manhattan), mientras Manhattan concentra el volumen diario de viajes.
- Dashboards interactivos en Looker Studio con top de zonas, demanda por hora y por mes, rutas más rentables y comparación de modelos.